1. Split per class
PDF meminta 80% baris pertama tiap class untuk training, sisanya untuk test, mengikuti urutan csv. Potongan dihitung di dalam tiap class, sesudah baris dikelompokkan menurut CLASS. 60 baris pertama hanya class 1, 2, dan 3. Class 4 mulai di baris 61. Kalau 80% diambil dari seluruh file, class 4 tidak masuk training data, dan 5-NN tidak bisa memprediksi 4.
Jumlah training = bilangan bulat terdekat dari 0,8 × n. Class 2: 13,6 dibulatkan ke 14. Class 3: 18,4 dibulatkan ke 18. Total 60 training dan 15 test. Baris berwarna di tabel adalah test.
| Class | n | Training | Test |
|---|---|---|---|
| 1 | 20 | 16 | 4 |
| 2 | 17 | 14 | 3 |
| 3 | 23 | 18 | 5 |
| 4 | 15 | 12 | 3 |
| Total | 75 | 60 | 15 |
Class 1
| No | X | Y | Peran |
|---|---|---|---|
| 1 | 4 | 53 | training |
| 2 | 5 | 63 | training |
| 3 | 10 | 59 | training |
| 4 | 9 | 77 | training |
| 5 | 13 | 49 | training |
| 6 | 13 | 69 | training |
| 7 | 12 | 88 | training |
| 8 | 15 | 75 | training |
| 9 | 18 | 61 | training |
| 10 | 19 | 65 | training |
| 11 | 22 | 74 | training |
| 12 | 27 | 72 | training |
| 13 | 28 | 76 | training |
| 14 | 24 | 58 | training |
| 15 | 27 | 55 | training |
| 16 | 28 | 60 | training |
| 17 | 30 | 52 | test |
| 18 | 31 | 60 | test |
| 19 | 32 | 61 | test |
| 20 | 36 | 72 | test |
Class 2
| No | X | Y | Peran |
|---|---|---|---|
| 21 | 86 | 132 | training |
| 22 | 85 | 115 | training |
| 23 | 85 | 96 | training |
| 24 | 78 | 94 | training |
| 25 | 74 | 96 | training |
| 26 | 97 | 122 | training |
| 27 | 98 | 116 | training |
| 28 | 98 | 124 | training |
| 29 | 99 | 119 | training |
| 30 | 99 | 128 | training |
| 31 | 101 | 115 | training |
| 32 | 108 | 111 | training |
| 33 | 110 | 111 | training |
| 34 | 108 | 116 | training |
| 35 | 111 | 126 | test |
| 36 | 115 | 117 | test |
| 37 | 117 | 115 | test |
Class 3
| No | X | Y | Peran |
|---|---|---|---|
| 38 | 28 | 147 | training |
| 39 | 32 | 149 | training |
| 40 | 35 | 153 | training |
| 41 | 33 | 154 | training |
| 42 | 38 | 151 | training |
| 43 | 41 | 150 | training |
| 44 | 38 | 145 | training |
| 45 | 38 | 143 | training |
| 46 | 32 | 143 | training |
| 47 | 34 | 141 | training |
| 48 | 44 | 156 | training |
| 49 | 44 | 149 | training |
| 50 | 44 | 143 | training |
| 51 | 46 | 142 | training |
| 52 | 47 | 149 | training |
| 53 | 49 | 152 | training |
| 54 | 50 | 142 | training |
| 55 | 53 | 144 | training |
| 56 | 52 | 152 | test |
| 57 | 55 | 155 | test |
| 58 | 54 | 124 | test |
| 59 | 60 | 136 | test |
| 60 | 63 | 139 | test |
Class 4
| No | X | Y | Peran |
|---|---|---|---|
| 61 | 70 | 4 | training |
| 62 | 77 | 12 | training |
| 63 | 83 | 21 | training |
| 64 | 61 | 15 | training |
| 65 | 69 | 15 | training |
| 66 | 78 | 16 | training |
| 67 | 66 | 18 | training |
| 68 | 58 | 13 | training |
| 69 | 64 | 20 | training |
| 70 | 69 | 21 | training |
| 71 | 66 | 23 | training |
| 72 | 61 | 25 | training |
| 73 | 76 | 27 | test |
| 74 | 72 | 31 | test |
| 75 | 64 | 30 | test |
2. Hasil 5-NN
Cuplikan tugas.py
predict
Jaraknya Euclidean distance. Kalau dua training data sama jauh, nomor baris yang lebih kecil yang diambil. Class label dipilih lewat voting 5 nearest training data.
def predict(point, train):
    nearest = sorted(
        train,
        key=lambda tr: (math.hypot(point[1] - tr[1], point[2] - tr[2]), tr[0]),
    )[:K]
    return Counter(tr[3] for tr in nearest).most_common(1)[0][0]
split
Kelompokkan menurut class, urutan csv tetap. 80% pertama dibulatkan: class 2 dari 13,6 jadi 14, class 3 dari 18,4 jadi 18. Sisanya test.
def split(rows):
    by = defaultdict(list)
    for row in rows:
        by[row[3]].append(row)
    train, test = [], []
    for label in sorted(by):
        items = by[label]
        n = round(len(items) * 0.8)
        train += items[:n]
        test += items[n:]
    return train, test
Keluarannya
python3 tugas.py, dengan 5. ruspini.csv di folder yang sama. Teks di bawah ini sama dengan yang tercetak.
$ python3 tugas.py

Total data   : 75
Data training: 60
Data testing : 15

 Titik uji | Asli | Prediksi | Status
--------------------------------------
(  30,  52) | 1 | 1 | benar
( 111, 126) | 2 | 2 | benar
(  54, 124) | 3 | 3 | benar
(  76,  27) | 4 | 4 | benar
... (15 data uji, semua benar) ...
--------------------------------------

Jumlah error : 0 dari 15
Error rate   : 0.00%
Akurasi      : 100.00%
3. Persen error
Soal meminta jumlah error seluruh test, dalam persen. Satu baris dihitung salah hanya kalau prediksi 5-NN tidak sama dengan CLASS di csv. Lima belas baris test dibandingkan satu per satu: baris 17–20 prediksi 1, baris 35–37 prediksi 2, baris 56–60 prediksi 3, baris 73–75 prediksi 4. Semuanya sama dengan class label. Tidak ada baris yang menang tipis: tiap voting 5 lawan 0, jadi 0% tidak bergantung pada 1 nearest neighbor.
error rate = (jumlah salah / jumlah test) × 100% = 0 / 15 × 100% = 0%
4. Analisis
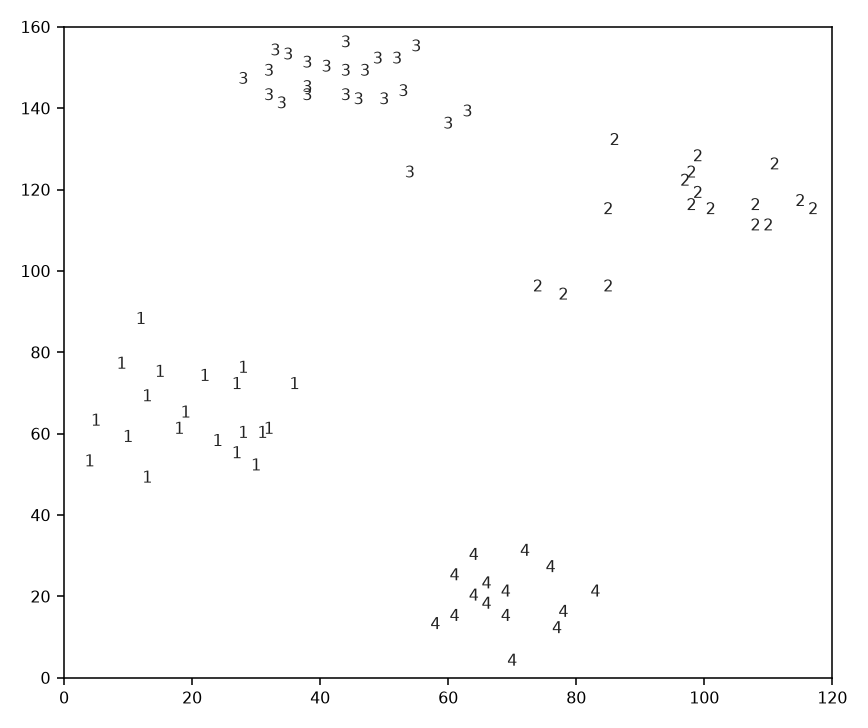
Empat kelompok di gambar itu terpisah: class 1 di kiri, class 3 di atas, class 2 di kanan atas, class 4 di kanan bawah. Pusat class kira-kira (20, 65), (98, 115), (44, 146), dan (69, 19). Sepanjang 75 baris, dua titik berbeda class yang paling dekat adalah baris 21 (86, 132), class 2, dan baris 60 (63, 139), class 3. Euclidean distance 24.04.
Prediksi berganti class kalau ada training data class lain di dalam 5 nearest neighbor. Tabel di bawah membandingkan jarak nearest neighbor ke-5 dengan jarak training data class lain yang terdekat. Selisih positif berarti 5 nearest neighbor masih satu class label dengan label asli.
| No | Class | Nearest neighbor ke-5 | Class lain terdekat | Jarak lain | Selisih |
|---|---|---|---|---|---|
| 17 | 1 | 17.03 | #72 class 4 | 41.11 | 24.08 |
| 18 | 1 | 13.00 | #72 class 4 | 46.10 | 33.10 |
| 19 | 1 | 13.60 | #72 class 4 | 46.23 | 32.63 |
| 20 | 1 | 18.38 | #25 class 2 | 44.94 | 26.56 |
| 35 | 2 | 14.56 | #55 class 3 | 60.73 | 46.17 |
| 36 | 2 | 16.12 | #55 class 3 | 67.62 | 51.50 |
| 37 | 2 | 18.44 | #55 class 3 | 70.26 | 51.82 |
| 56 | 3 | 8.94 | #21 class 2 | 39.45 | 30.50 |
| 57 | 3 | 12.53 | #21 class 2 | 38.60 | 26.07 |
| 58 | 3 | 24.84 | #22 class 2 | 32.28 | 7.44 |
| 59 | 3 | 18.38 | #21 class 2 | 26.31 | 7.92 |
| 60 | 3 | 19.10 | #21 class 2 | 24.04 | 4.94 |
| 73 | 4 | 13.45 | #15 class 1 | 56.44 | 42.98 |
| 74 | 4 | 14.32 | #15 class 1 | 51.00 | 36.68 |
| 75 | 4 | 12.17 | #15 class 1 | 44.65 | 32.49 |
Selisih paling kecil ada di baris 60: nearest neighbor ke-5 berjarak 19.10, baris 21 class 2 berjarak 24.04, selisih 4.94. Baris 58 (54, 124) duduk di bawah kawanan class 3. Nearest neighbor ke-5-nya, baris 45, berjarak 24.84. Titik class lain terdekat, baris 22 class 2, berjarak 32.28. Selisihnya 7.44, lebih besar daripada selisih baris 60.
Lima belas baris itu voting 5 lawan 0, jadi error rate pada pecahan ini 0%. Pengecekan tambahan: memotong dengan int(n × 0,8) tanpa pembulatan memindahkan baris 34 ke test. Enam belas titik test pada potongan itu tetap terprediksi benar. Di simulasi, lingkaran isi = training, cincin = test, garis = 5 nearest neighbor titik yang dipilih.