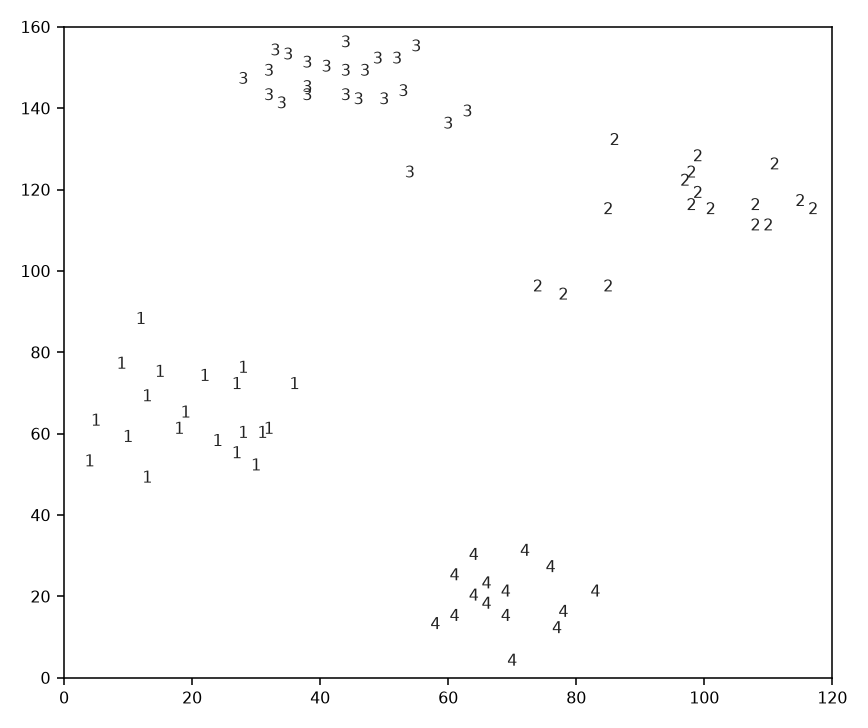
Empat kelompok jauh di plot → 5 nearest neighbor tidak campur class.
Bahan
75 baris, dua kolom, empat class
File 5. ruspini.csv. Satu baris = satu titik (X, Y) plus CLASS.
Class
Jumlah
Baris di csv
1
20
1–20
2
17
21–37
3
23
38–60
4
15
61–75
Total
75
PDF: 80% baris pertama tiap class label untuk training, sisa baris untuk test, lalu 5-NN. Enam puluh baris pertama hanya class 1, 2, dan 3. Class 4 mulai di baris 61. Kalau 80% diambil dari seluruh file sekaligus, class 4 tidak masuk training data.
1 · Split per class
Hitung 80% di dalam tiap class
Baca csv dari atas ke bawah. Urutan file tetap.
Kumpulkan baris class 1, lalu class 2, dan seterusnya.
Lalu ambil 80% baris paling awal di class itu untuk training.
Class 2 punya 17 baris dan class 3 punya 23. Jumlah training baru bisa dihitung sesudah tiap class terkumpul.
1 · Berapa baris training
Bulatkan 0,8 × n
n training = bilangan bulat terdekat dari 0,8 × n class
Sisa baris di daftar itu = test.
Class
n
0,8 × n
Training
Test
1
20
16
16
4
2
17
13,6
14
3
3
23
18,4
18
5
4
15
12
12
3
Total
75
60
15
Class 1 dan 4 pas. Class 2: 13,6 dibulatkan ke 14. Class 3: 18,4 dibulatkan ke 18. Total 60 training dan 15 test.
1 · Baris mana
Baris awal jadi training
Di tiap class, baris yang lebih dulu muncul di csv, sebanyak n training, masuk training. Baris di belakangnya masuk test. Class-nya tidak berubah.
Class
Training
Test
1
1–16
17–20
2
21–34
35–37
3
38–55
56–60
4
61–72
73–75
Class 1: baris 17 (30, 52), 18 (31, 60), 19 (32, 61), dan 20 (36, 72) masuk test. Daftar titik tiap class ada di halaman tugas.
2 · Hasil 5-NN
Kode di tugas.py
predict
Euclidean distance. Kalau dua training sama jauh, baris csv yang lebih kecil menang. Class label = majority vote dari 5 nearest neighbor.
Kelompokkan menurut class. 80% pertama dibulatkan. Class 2: 13,6 jadi 14. Class 3: 18,4 jadi 18. Sisanya test.
defsplit(rows):
by = defaultdict(list)
for row in rows:
by[row[3]].append(row)
train, test = [], []
for label in sorted(by):
items = by[label]
n = round(len(items) * 0.8)
train += items[:n]
test += items[n:]
return train, test
2 · Hasil 5-NN
Keluarannya
python3 tugas.py, dengan 5. ruspini.csv di folder yang sama. Satu contoh per class. Class 3 yang tampil adalah (54, 124).
tugas.py
$ python3 tugas.py

Total data   : 75
Data training: 60
Data testing : 15

 Titik uji | Asli | Prediksi | Status
--------------------------------------
(  30,  52) | 1 | 1 | benar
( 111, 126) | 2 | 2 | benar
(  54, 124) | 3 | 3 | benar
(  76,  27) | 4 | 4 | benar
... (15 data uji, semua benar) ...
--------------------------------------

Jumlah error : 0 dari 15
Error rate   : 0.00%
Akurasi      : 100.00%
3 · Persen error
0 salah dari 15 test
error rate = (jumlah salah / jumlah test) × 100% = 0 / 15 × 100% = 0%
Salah hanya kalau prediksi tidak sama dengan class label. Baris 17–20 prediksi 1, 35–37 prediksi 2, 56–60 prediksi 3, 73–75 prediksi 4.
Setiap titik test: 5 training paling dekat semuanya class yang sama dengan label asli. Majority vote otomatis benar.
4 · Analisis eksperimen
Mengapa error rate 0%?
Cluster terpisah jelas. Empat class membentuk empat cluster di plot: class 1 kiri, class 3 atas, class 2 kanan atas, class 4 kanan bawah.
Dua titik beda class yang paling dekat di seluruh csv, baris 21 (class 2) dan baris 60 (class 3), jarak 24,04.
Aturan 5-NN. Untuk tiap titik test: urutkan 60 training by distance, ambil 5 nearest neighbor, majority vote.
Prediksi salah hanya kalau ada training class lain ikut masuk 5 itu.
Hasil 15 test (17–20, 35–37, 56–60, 73–75). Tiap titik: ambil 5 training paling dekat.
Kelimanya selalu class yang sama dengan class titik itu di csv, karena training class lain jaraknya lebih jauh (lebih jauh dari training ke-5).
Majority vote = class di csv, prediksi benar. Begitu untuk semua 15 titik, error 0%.
k = 5 sesuai soal. k = 1 pada Ruspini ini juga benar; k terlalu besar bisa menarik training dari cluster lain pada data yang rapat.
Selesai
Error pada pecahan ini 0%
60 training, 15 test. 5 nearest neighbor selalu satu class dengan label asli.
int(n × 0,8) tanpa round: baris 34 ikut test, 16 titik tetap benar.
Tabel lengkap
dan
simulasi
(lingkaran isi = training, cincin = test, garis = 5 nearest neighbor).
Keluaran yang sama ada di tugas.py.