holdout.py
Holdout
Tiap class: 80% baris awal untuk training, sisanya test. 50 × 0,8 = 40, jadi 10 test per class. Training: baris 1–40, 51–90, 101–140. Test: 41–50, 91–100, 141–150.
for label in ("setosa", "versicolor", "virginica"):
    items = by[label]
    n = round(len(items) * 0.8)
    train += items[:n]
    test += items[n:]
wrong = []
ties = 0
for point in test:
    pred, tied = predict(point, train)
    ties += tied
    if pred != point[5]:
        wrong.append(point[0])
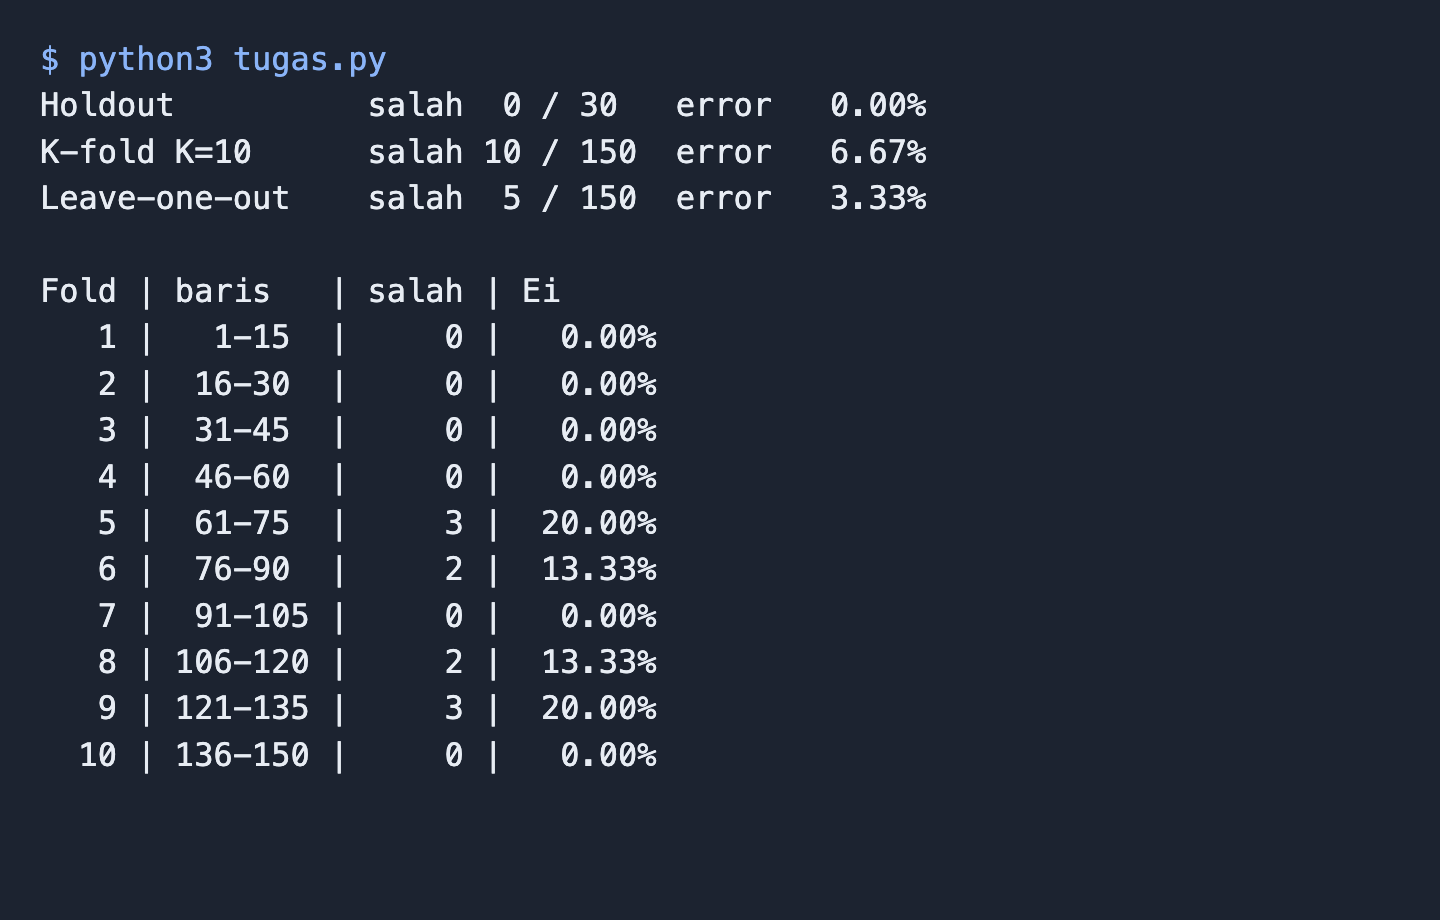
print(f"{'Holdout':<16} salah {len(wrong):2} / {len(test):<3}  error {percent(wrong, len(test)):6.2f}%")
Hasil
0%
0 salah dari 30 data test. Semua prediksi sama dengan class-nya.
kfold.py
K-fold, K = 10
10 fold berurutan. Tiap fold 15 baris untuk test, sisanya training. Tiap fold sama besar, jadi rata-rata error sama dengan jumlah salah dibagi 150.
size = len(rows) // FOLDS
folds = []
ties = 0
for fold in range(FOLDS):
    test = rows[fold * size : (fold + 1) * size]
    train = rows[: fold * size] + rows[(fold + 1) * size :]
    wrong = []
    for point in test:
        pred, tied = predict(point, train)
        ties += tied
        if pred != point[5]:
            wrong.append(point[0])
    folds.append((test, wrong))
wrong = [no for _, fold_wrong in folds for no in fold_wrong]
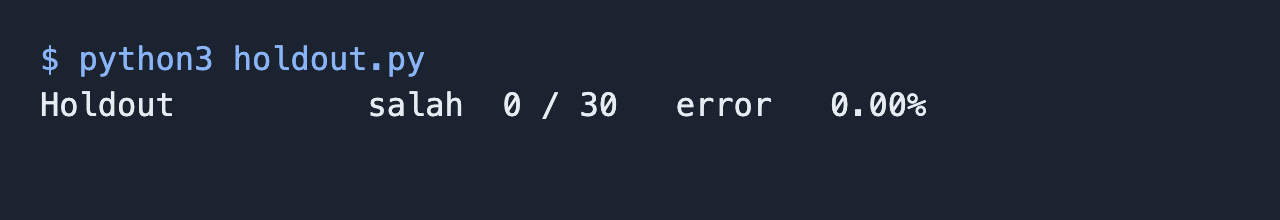
print(f"{'K-fold K=10':<16} salah {len(wrong):2} / {len(rows):<3}  error {percent(wrong, len(rows)):6.2f}%")
Hasil
6,67%
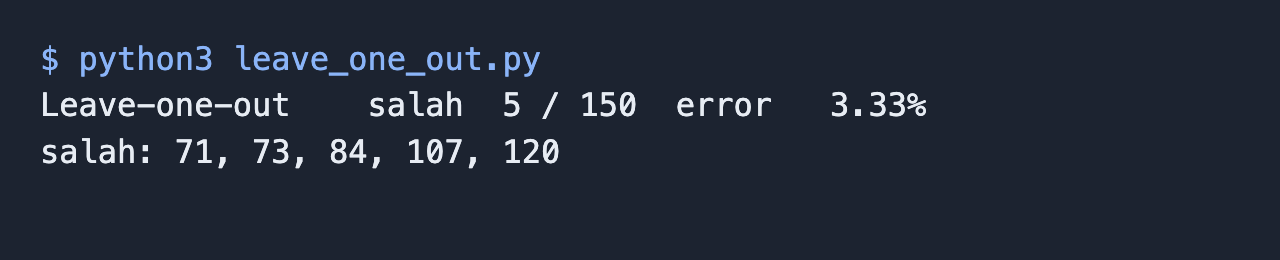
10 salah dari 150. Semuanya versicolor tertukar dengan virginica. Fold 5 dan 9 salah 3. Fold 6 dan 8 salah 2. Fold lain tidak salah.
leave_one_out.py
Leave-one-out
150 kali. Satu baris untuk test, 149 baris untuk training.
wrong = []
ties = 0
for i, point in enumerate(rows):
    train = rows[:i] + rows[i + 1 :]
    pred, tied = predict(point, train)
    ties += tied
    if pred != point[5]:
        wrong.append(point[0])
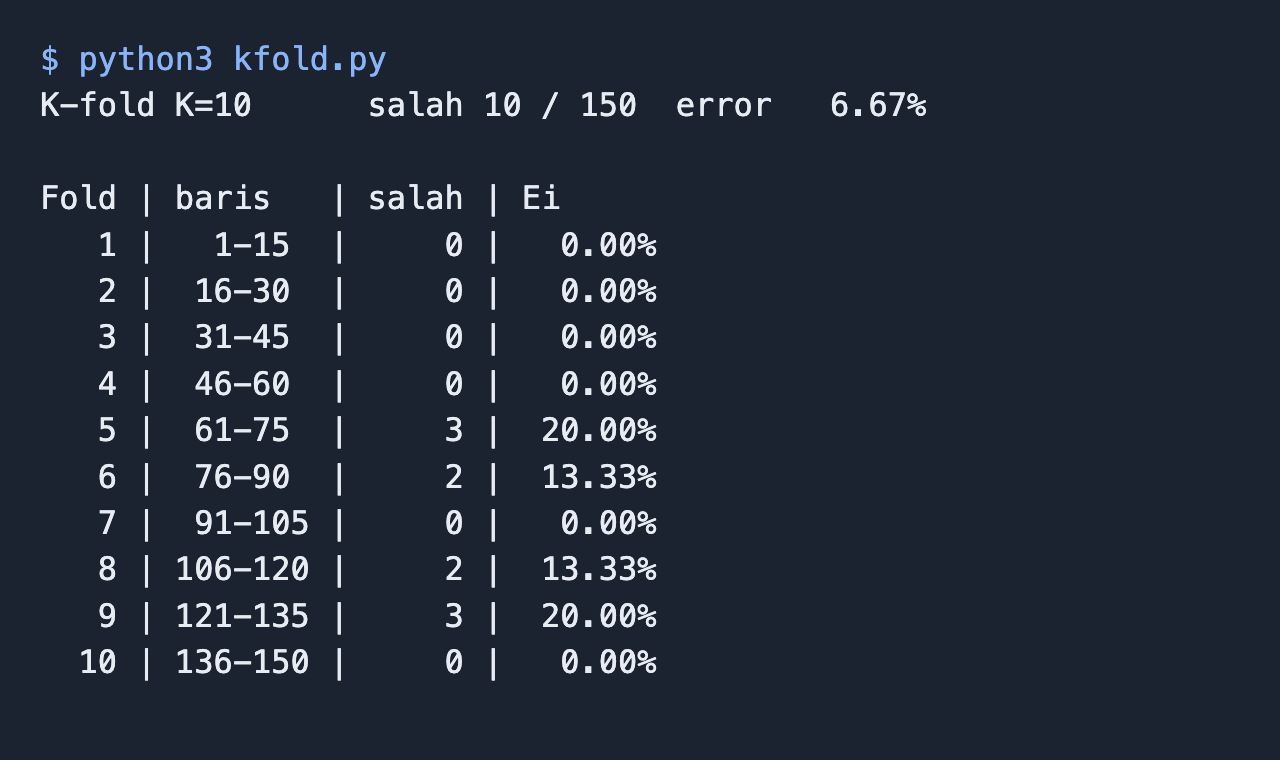
print(f"{'Leave-one-out':<16} salah {len(wrong):2} / {len(rows):<3}  error {percent(wrong, len(rows)):6.2f}%")
Hasil
3,33%
5 salah dari 150. Baris 71, 73, dan 84 versicolor, diprediksi virginica. Baris 107 dan 120 virginica, diprediksi versicolor.
knn.py · k-NN (k=5)
k-NN, k = 5
Tiap data test diukur ke data training dengan jarak Euclidean. Empat atribut dipakai apa adanya. Ambil 5 tetangga terdekat. Kalau jaraknya sama, nomor baris yang lebih kecil yang dipakai. Class-nya suara terbanyak. Tidak ada suara seri.
Error = (jumlah salah / jumlah data test) × 100%
def predict(point, train):
    nearest = sorted(train, key=lambda tr: (math.dist(point[1:5], tr[1:5]), tr[0]))[:KNN]
    ranked = Counter(tr[5] for tr in nearest).most_common()
    tied = len(ranked) > 1 and ranked[0][1] == ranked[1][1]
    return ranked[0][0], tied

def percent(wrong, total):
    return len(wrong) / total * 100
Hasil
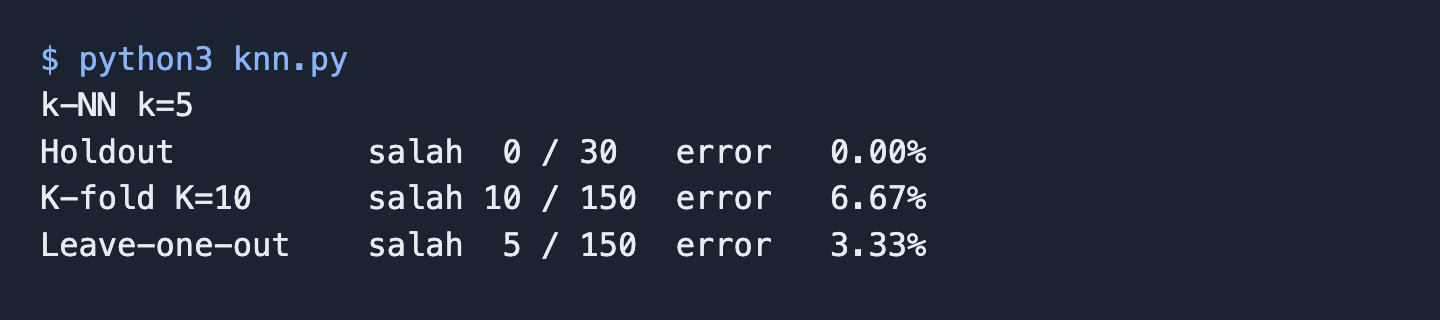
Prediksi salah kalau class-nya beda dengan label. Holdout 0%, K-fold 6,67%, leave-one-out 3,33%.
Rata-rata error
Rata-rata error
Setosa tidak pernah salah. Semua salah ada di batas versicolor dan virginica.
Holdout 0% karena lima baris yang sulit (71, 73, 84, 107, 120) masuk training, dan 30 baris test-nya mudah ditebak. K-fold paling tinggi, 6,67%. Satu blok 15 baris keluar sekaligus, jadi tetangga yang seharusnya memilih class yang benar ikut keluar. Leave-one-out 3,33%. Tetangga dekat masih ada di training, jadi 5 dari 10 salah K-fold kembali benar.
Holdout: 0 / 30 × 100% = 0%
K-fold (K = 10): 10 / 150 × 100% = 6,67%
Leave-one-out: 5 / 150 × 100% = 3,33%